


Vous connaissez grep ? L’outil en ligne de commande qui est dispo sur presque toutes les distributions et qui sert aussi bien à filtrer une sortie de console qu’à fouiller dans des fichiers. Eh bien aujourd’hui, je vous présente une alternative plutôt sympathique, pensée pour vous, humains, mais aussi pour vos agents IA. Très pratique pour ceux qui développent avec des outils Claude Code ou OpenCode.
Si vous développez, grep fait partie des meubles. Pour filtrer des logs, il reste imbattable. Vous cherchez une erreur sans trop savoir par où commencer ? Un petit :
cat nomdufichier.log | grep errorEt hop, vous ne gardez que les lignes qui matchent. On peut pousser le bouchon un peu plus loin et s’en servir pour fouiller dans le code source. Toutes les occurrences de InvoiceController, par exemple :
grep -R InvoiceController .
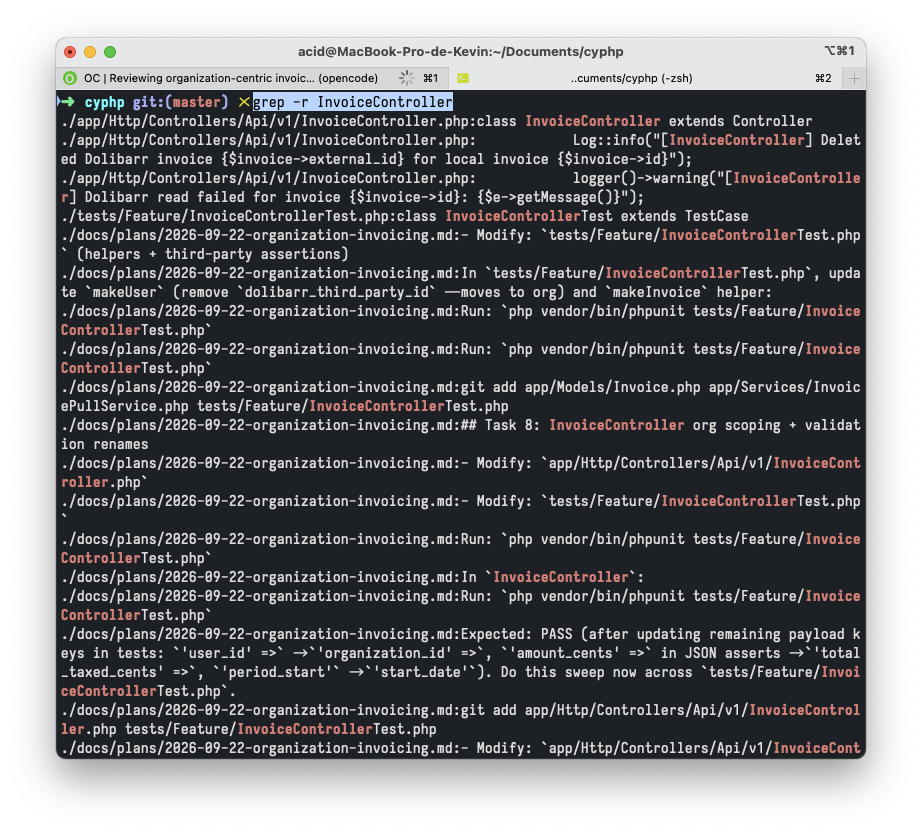
Ça marche. Mais sur un gros dépôt, vous récupérez souvent un mur de lignes, sans vrai classement. Et surtout, ça ne vous aide pas quand vous ne connaissez pas le nom exact de la classe, du fichier ou du symbole.
ripgrep (rg), codé en Rust, fait déjà beaucoup mieux pour ce job : plus rapide, plus malin avec les .gitignore, moins de bruit. Sauf que ça reste une recherche littérale. Vous lui demandez « où est-ce qu’on recrée une facture à partir d’une commande ? », et là, grep comme rg vous regardent avec des yeux de merlan frit. Bien sûr un LLM peut s’en charger à votre place. On pourrait s’appuyer sur un RLCD comme Jev mais on aime bien rester local ici.
C’est là qu’entre en scène zg. Oui, c’est le petit nom de zvec-grep. L’idée n’est pas de réinventer grep pour le plaisir. C’est de réunir trois façons de chercher derrière une seule commande, en local :
- la recherche exacte, façon ripgrep, quand vous connaissez le mot ou la regex ;
- la recherche par mots-clés (BM25), classée par pertinence ;
- la recherche vectorielle, quand vous décrivez une idée sans connaître le nom du symbole.
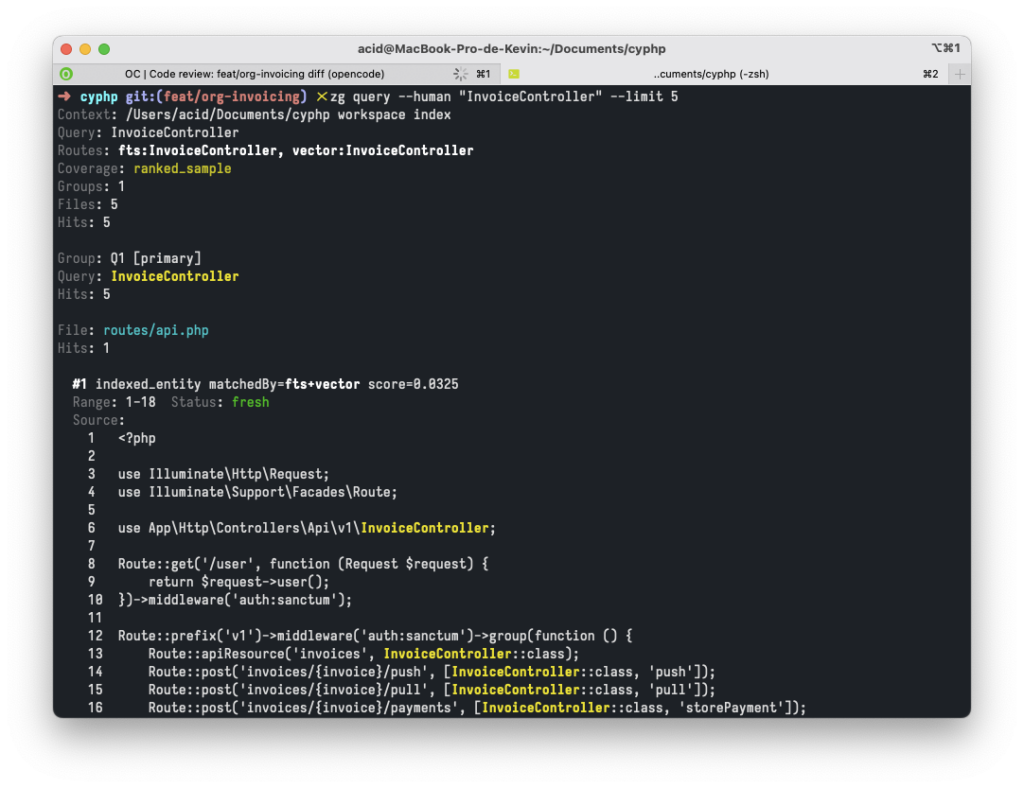
Vous l’utilisez dans le terminal, ou vous le branchez à votre agent. Même index, mêmes résultats. Et sur un gros projet ça se ressent. Au lieu de cracher des quantités de lignes, on a à la place une sortie plutôt user friendly. On se retrouve avec un résultat où il y a les fichiers et les lignes en plus d’une colorisation de votre requête. Pratique pour tout vérifier.
Le point qui compte vraiment : par défaut, tout reste sur votre machine. ZG récupère un modèle depuis Hugging Face et le fait tourner sur votre machine. Rien ne part dans le cloud, sauf si vous choisissez explicitement un modèle distant, mais là il faut une clé API.
Comment on l’installe ?
C’est bien beau tout ça Kévin, mais comment est-ce qu’on fait pour avoir zg en pratique ? Côté prérequis, il vous faut Node.js 22 ou plus récent, et bien sûr npm. Ça tourne sur macOS, Linux et Windows.
L’installation, c’est deux lignes :
npm install -g @zvec/zvec-grep
zg version
Sachez que la documentation officielle et le code source est disponible sur GitHub : https://github.com/zvec-ai/zvec-grep
Indexer le projet
Avant de faire des requêtes ou de poser des questions comme à un chatbot, il faut indexer le dépôt.
Placez-vous à la racine du projet :
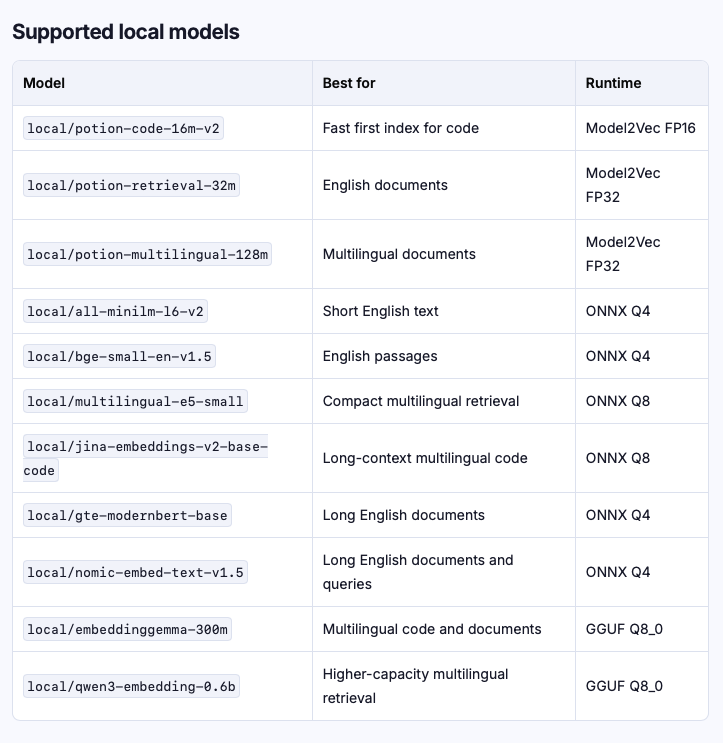
zg index --embedding local/potion-code-16m-v2
zg statuslocal/potion-code-16m-v2, c’est le modèle de petite taille recommandé pour un premier index de code. Léger, rapide et il ne consomme pas beaucoup de RAM. Au premier lancement, les fichiers du modèle sont téléchargés puis mis en cache dans ~/.zvec-grep/models. L’index, lui, atterrit dans .zvec-grep/ à la racine du projet, et ce dossier est exclu des recherches suivantes. Pratique, mais il faut juste penser à ne pas indexer ces dossiers avec Git.
Avec un modèle local/..., le contenu du workspace et le texte de vos requêtes restent sur la machine. C’est le mode que je vous recommande par défaut, et c’est celui des exemples au-dessus. Niveau vie privée, c’est nickel.

Sur un très gros dépôt, autant limiter le périmètre dès le départ, histoire de ne pas indexer dist, vendor et toute la quincaillerie :
zg index \
  --embedding local/potion-code-16m-v2 \
  -g "src/**" \
  -g "docs/**" \
  -g "node_modules/**" \
  -g "!dist/**"
Ensuite, pour remettre l’index à jour après vos modifs, un simple zg index suffit. Il reprend le même modèle. Si vous voulez en changer, là il faut reconstruire. Par exemple avec un modèle un peu plus costaud, orienté code et long contexte :
zg index --rebuild --embedding local/jina-embeddings-v2-base-codeComment on l’utilise ?
Vous avez deux façons d’utiliser zg. En tant qu’humain avec une interface orienté recherche dans du code ou des documents. Ou sinon, vous laissez faire votre agent IA préféré.
L’utiliser en tant que humain
Une fois l’index prêt, la commande du quotidien, c’est zg query. La recherche par défaut est hybride : elle mélange le sens et les mots-clés, puis vous renvoie un échantillon classé, avec les chemins et les lignes. Le flag --human rend ça lisible dans le terminal.
zg query --human "InvoiceController" --limit 5
Et si vous voulez juste l’équivalent d’un grep exhaustif, pas la peine de ressortir l’autre outil. zg embarque ripgrep, et cette voie-là n’a même pas besoin d’index :
zg query --rg -n -F "InvoiceController" srcEn gros : vous ne savez pas comment c’est formulé dans le code, vous passez par zg query. Vous connaissez le symbole ou la regex, vous passez par zg query --rg. Ou par votre rg habituel. Personne ne vous en voudra.
Le brancher à un agent
Là où zg devient vraiment intéressant, c’est avec les agents. Une fois l’index construit, vous le connectez en une commande. Ça parle MCP, en local, sans monter un serveur à la main :
zg install --target claude --yesLes cibles supportées sont Codex, Claude Code, Qwen Code, Cursor et OpenCode. Vous pouvez en brancher plusieurs d’un coup :
zg install --target cursor --target codex --yesEnsuite, redémarrez l’agent ou ouvrez une nouvelle session. Il dispose alors d’un outil, zvec_grep_search, qui lui renvoie des extraits courts, reliés au fichier et à la ligne. Moins de scans sauvages du dépôt, moins de tokens brûlés, et des réponses que vous pouvez vérifier au lieu de les croire sur parole.
Petit détail, et il est important : zg ne remplace pas le grep natif de l’agent. Si la question est un mot exact, un nom de fichier ou une regex, l’agent continue d’utiliser rg. zg sert quand l’emplacement est inconnu, ou quand il faut recouper plusieurs fichiers. La création et la suppression d’index restent des actions manuelles. L’agent ne va pas réindexer votre dépôt dans votre dos.
Pour retirer le branchement :
zg uninstall --target claude --yesÇa retire uniquement la config gérée par zvec-grep. Ni le paquet npm, ni vos index.
Pour résumer
grep et ripgrep restent vos meilleurs amis pour une chaîne exacte. zg prend le relais quand vous cherchez une idée, pas un mot. Un index local, une commande, et le même socle pour vous et pour votre agent.
La page Embedding models vaut le détour avant de lancer un gros index. Armez-vous de patience avec les modèles les plus gros.